多変量ロジスティック回帰分析の読み方|インフォグラフィックと図(原寸拡大)

画像をタップすると原寸のPNG画像が開きます。図の数値は、説明のために作った架空の例です。

全体要約:多変量ロジスティック回帰の読み方
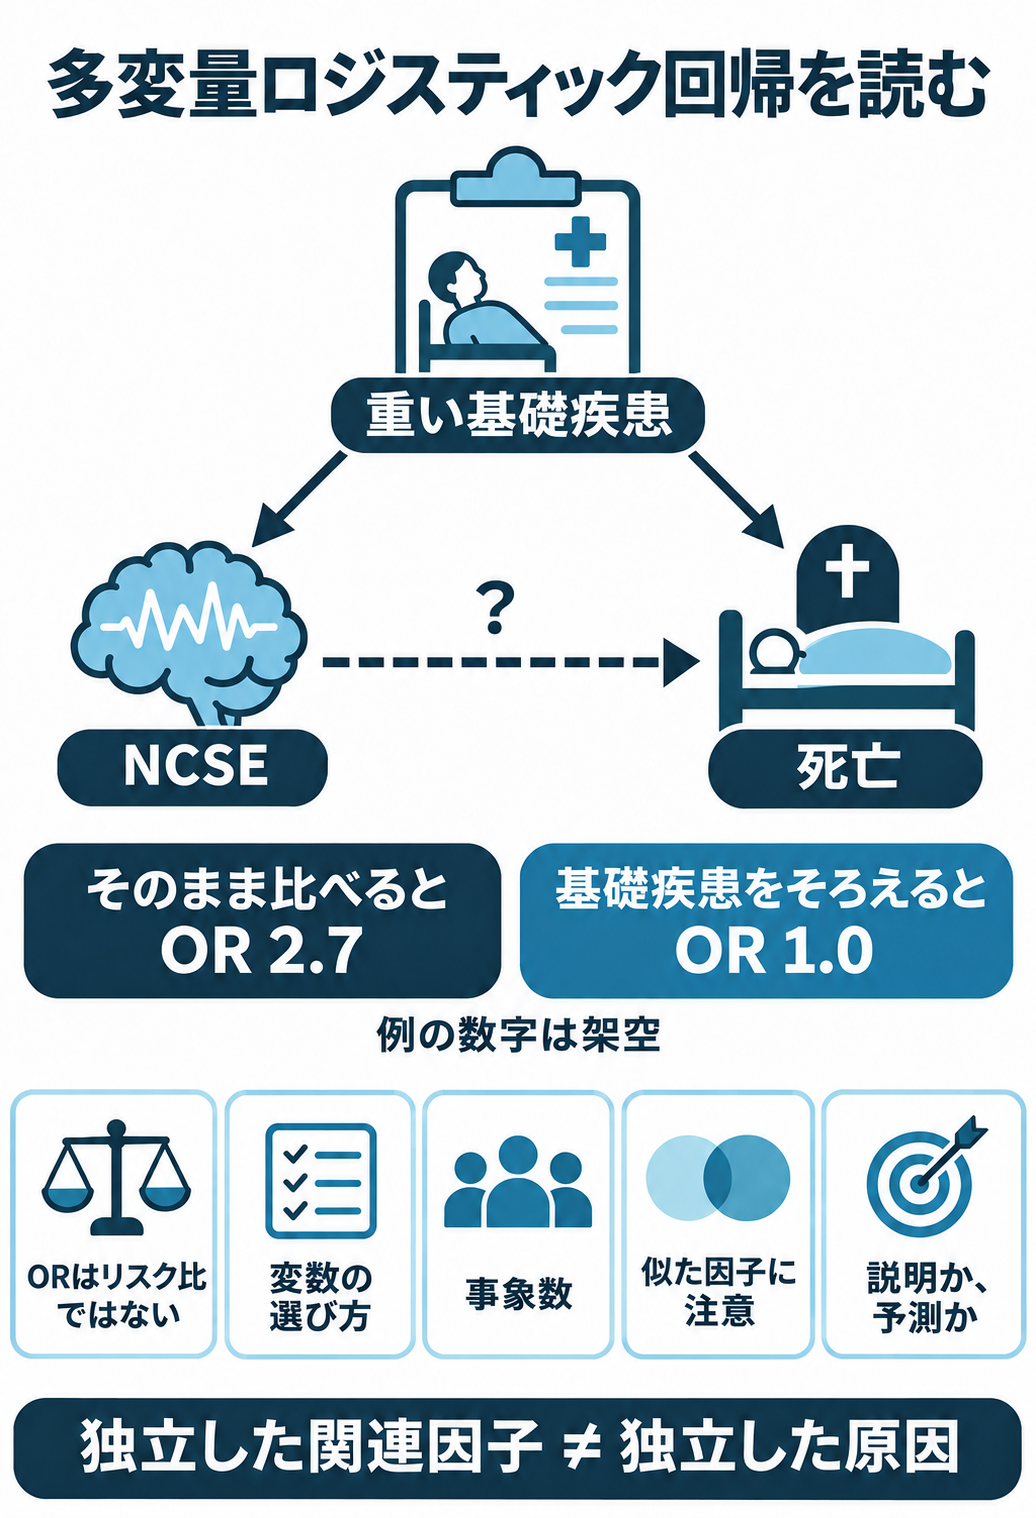
多変量ロジスティック回帰の全体像。重い基礎疾患が、NCSEと死亡の両方に関わると、全体では関連があるように見える。基礎疾患をそろえて調べると、NCSEのオッズ比は1.0になる。読むときは、オッズ比とリスク比の違い、変数の選び方、事象数、似た因子の同時投入、説明か予測かを確かめる

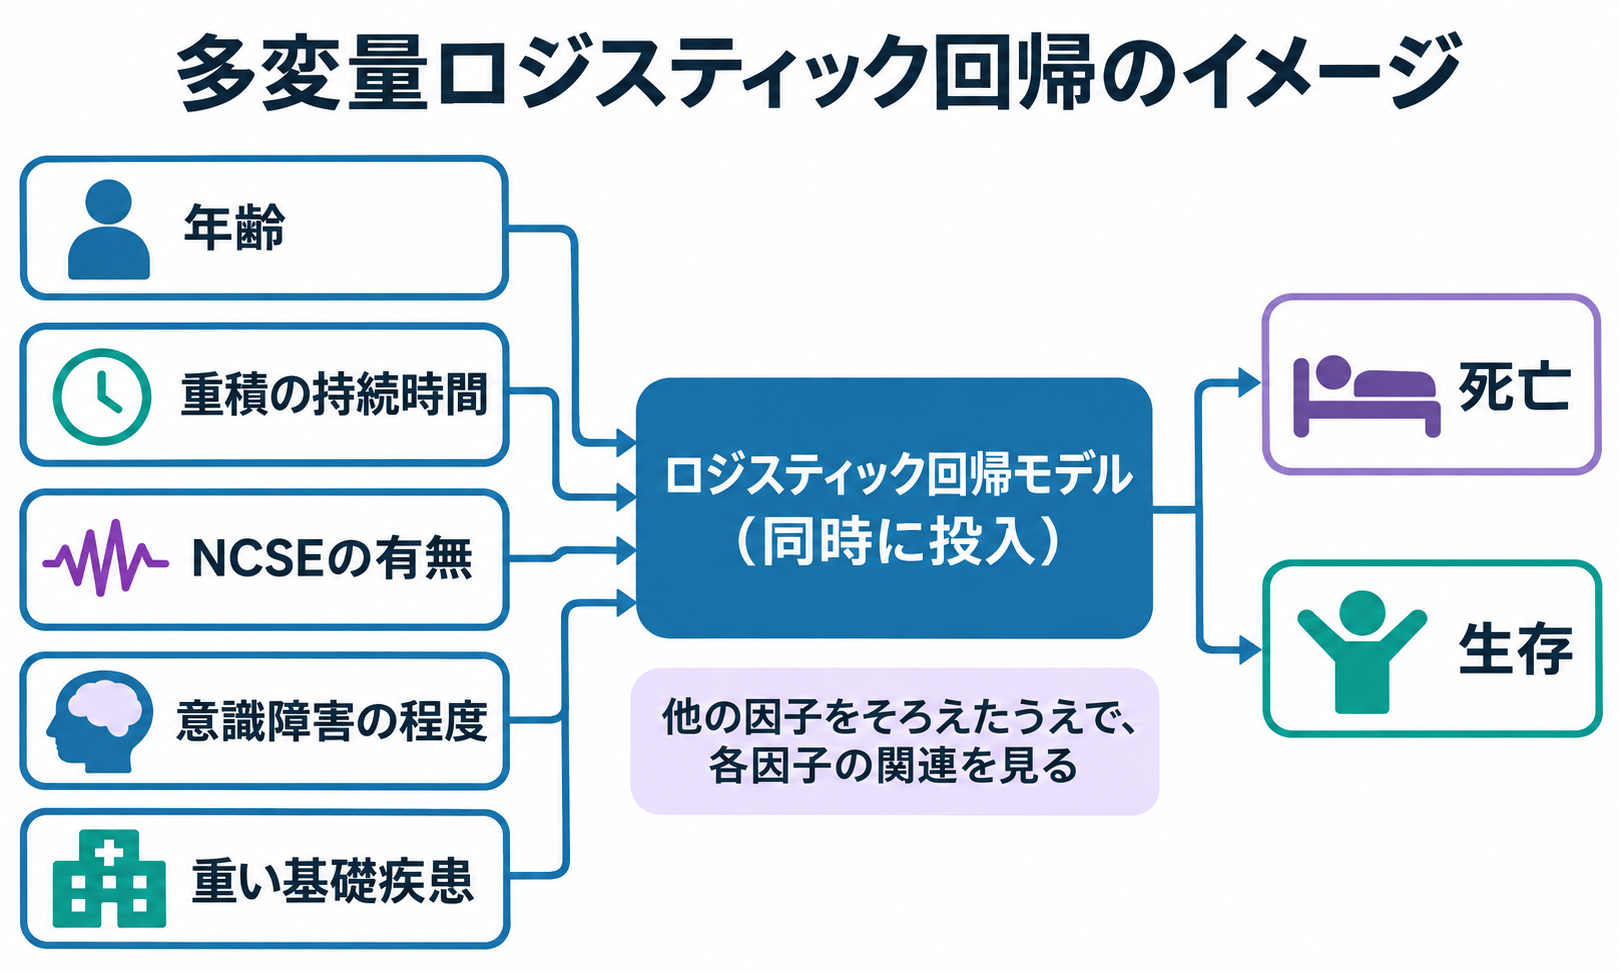
図1:複数の因子を同時にモデルへ入れる

多変量ロジスティック回帰のイメージ。年齢、重積の持続時間、NCSEの有無、意識障害の程度、重い基礎疾患の5つの因子を同時にモデルへ入れ、死亡か生存かを説明する

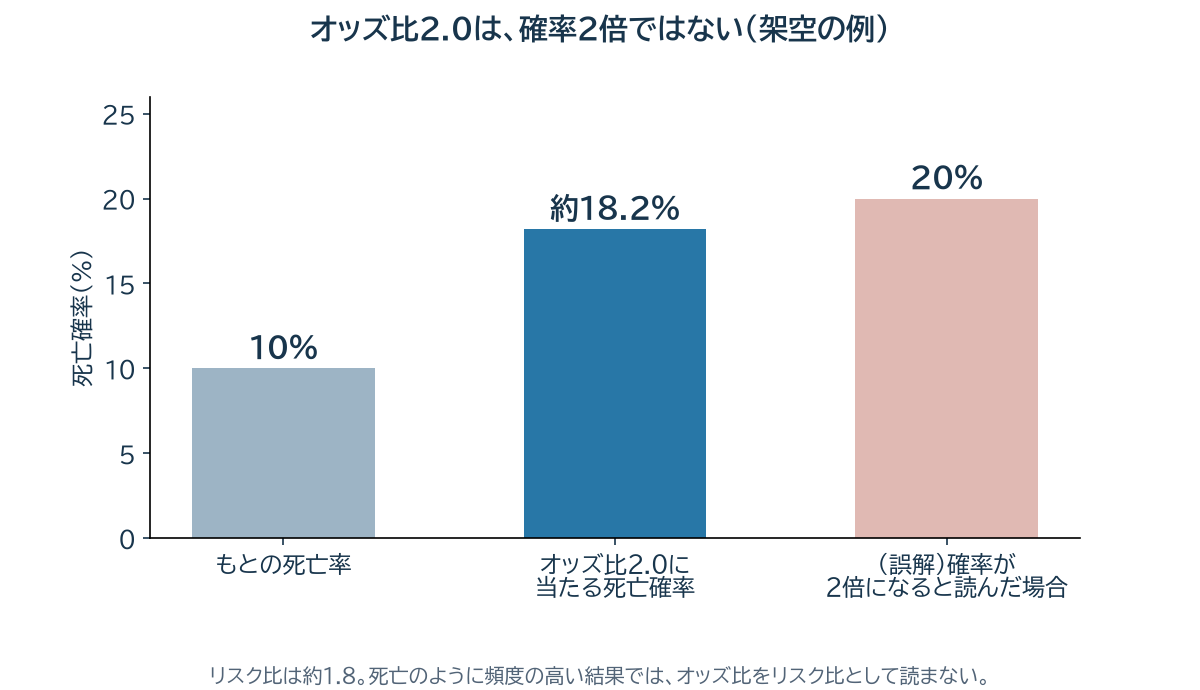
図2:オッズ比とリスク比の違い

もとの死亡率10%の集団でオッズ比2.0のとき、死亡確率は約18.2%で、20%ではない。リスク比は約1.8

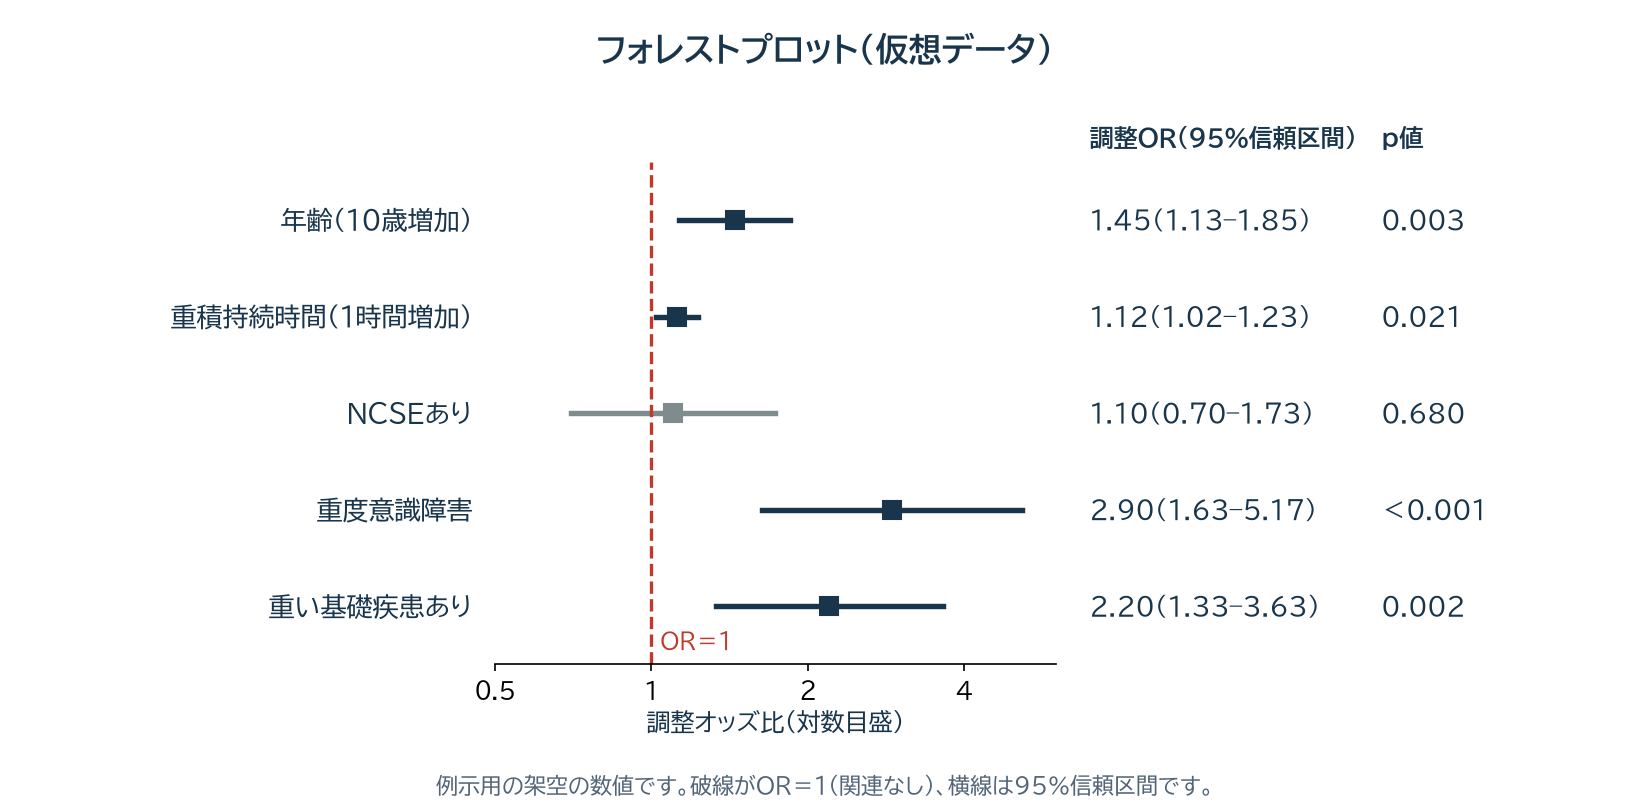
図3:フォレストプロット(仮想データ)

フォレストプロット(仮想データ)。破線がOR=1。年齢、重積持続時間、重度意識障害、重い基礎疾患の95%信頼区間は1をまたがず、NCSEの95%信頼区間は1をまたぐ

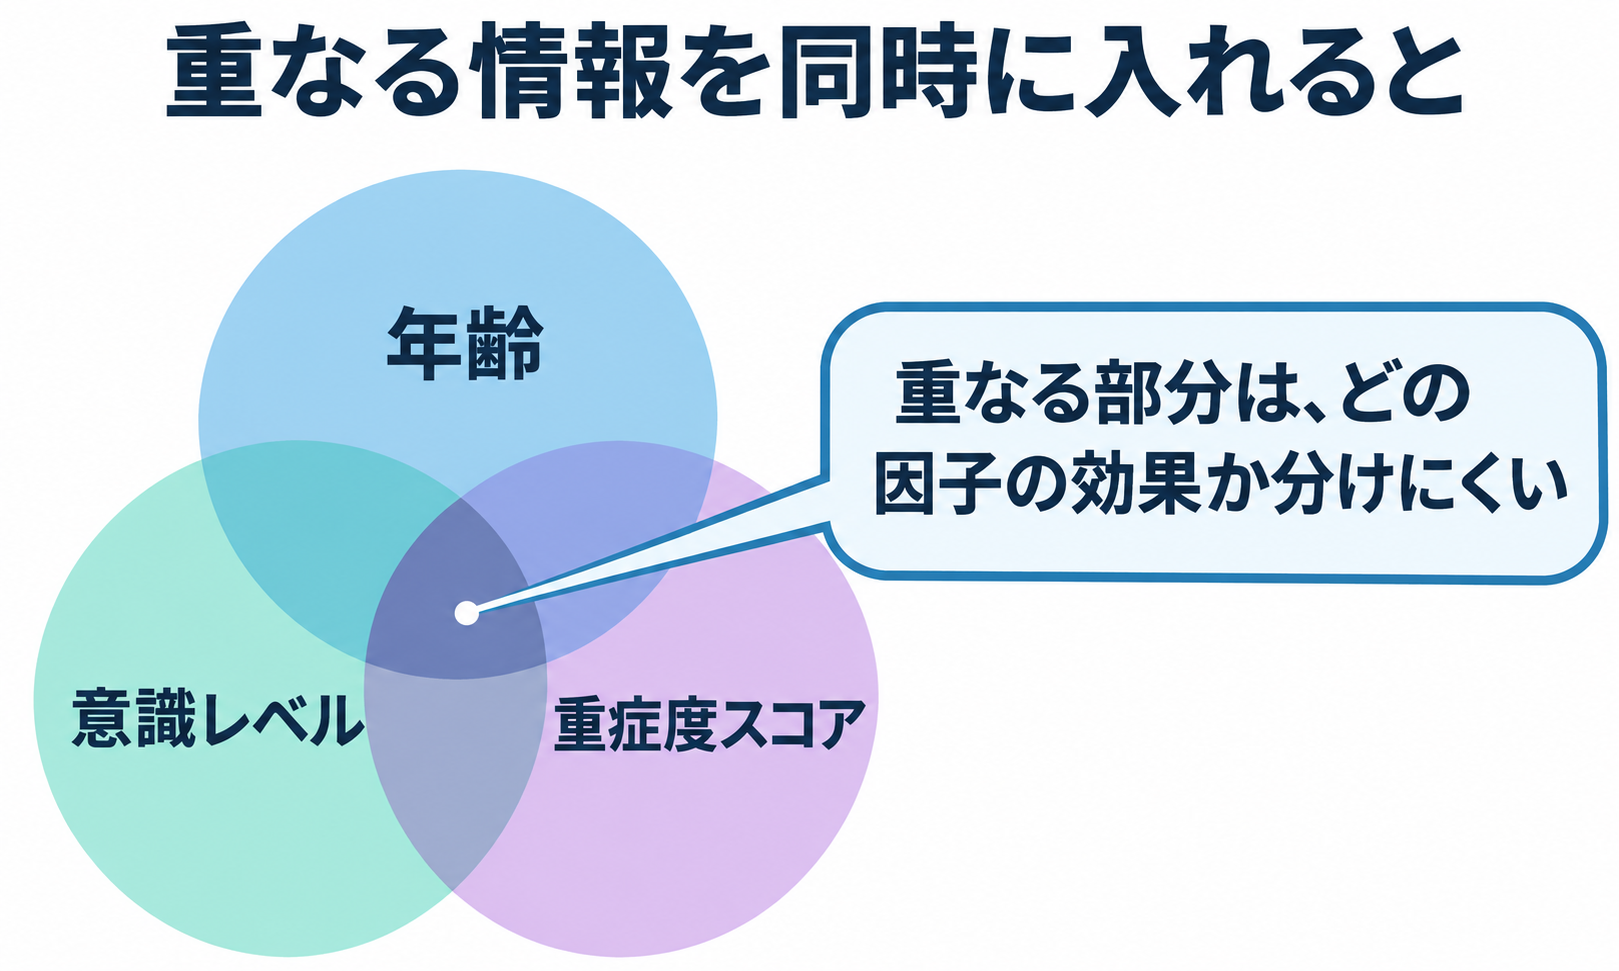
図4:似た因子の同時投入

年齢、意識レベル、重症度スコアの3つの円が大きく重なっている。重なる部分は、どの因子の効果か分けにくい

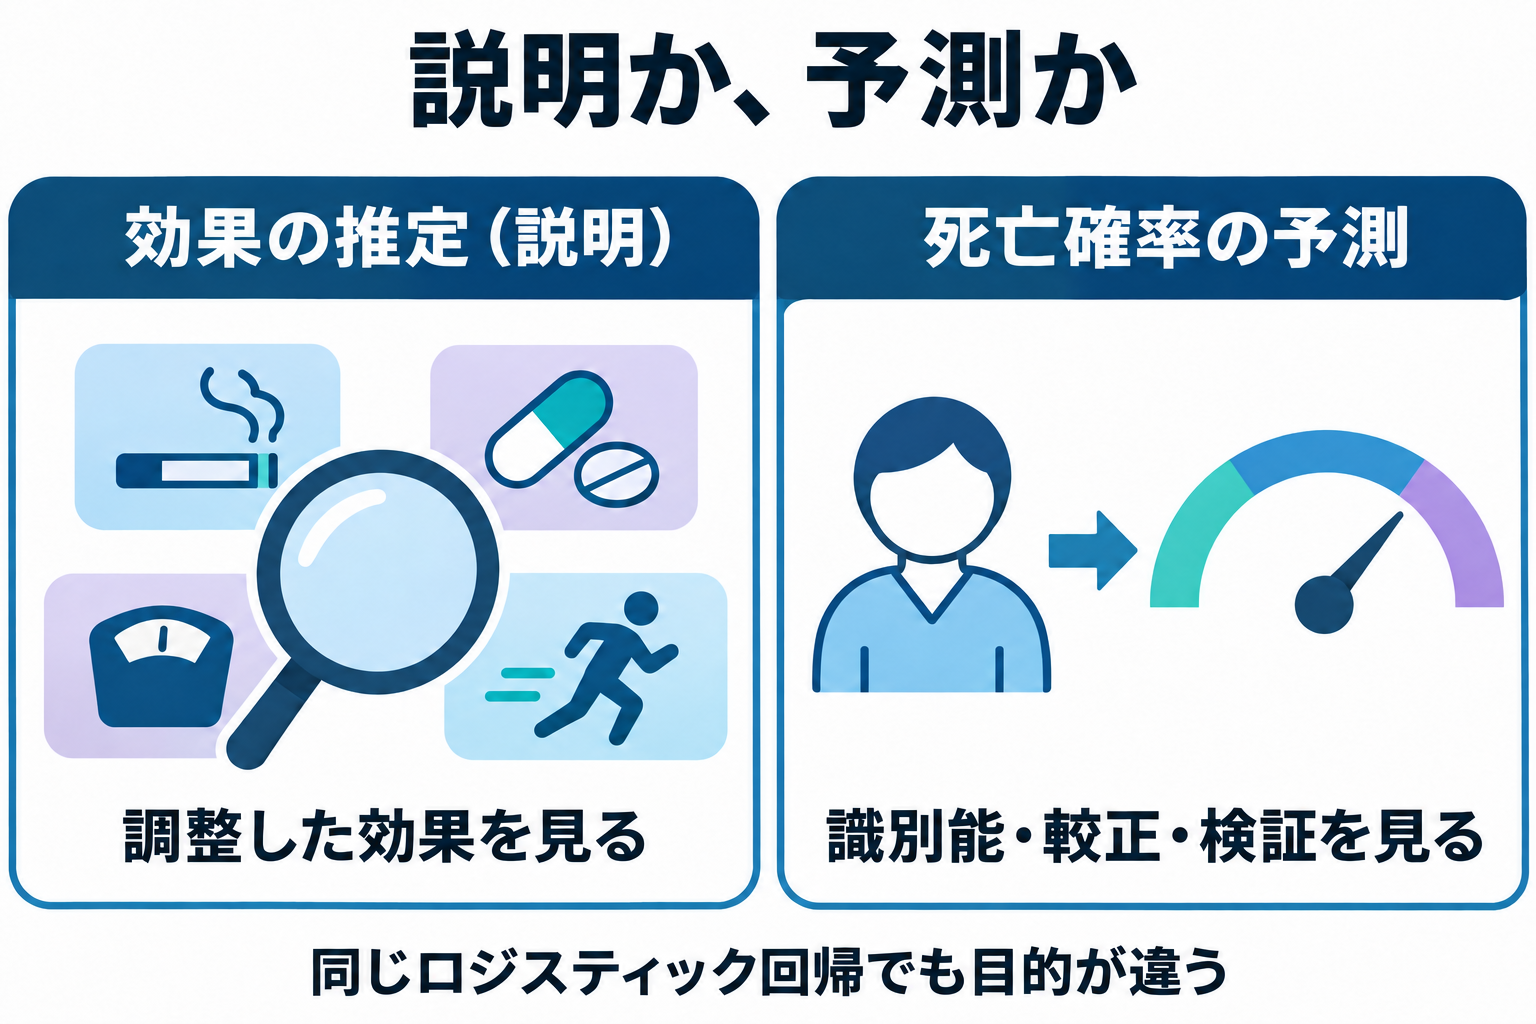
図5:説明か、予測か

説明か、予測か。左は効果の推定(説明)で、調整した効果を見る。右は死亡確率の予測で、識別能・較正・検証を見る